大家好,我是Zleap的创始人Jomy。我最近在做算法设计和系统架构时,我越来越清晰地意识到一件事:
只靠纯算法,不可靠;只靠纯向量(Embedding),不可靠;只靠纯 LLM,更不可靠。
真正能落地、稳定、可维护的智能系统,一定是:算法 + 向量 + LLM 的组合拳。
而支撑这一切的底层逻辑,我用一句话概括为:
有多少计算,就有多少智能。
我把这句话叫作:AI 热力学定律。
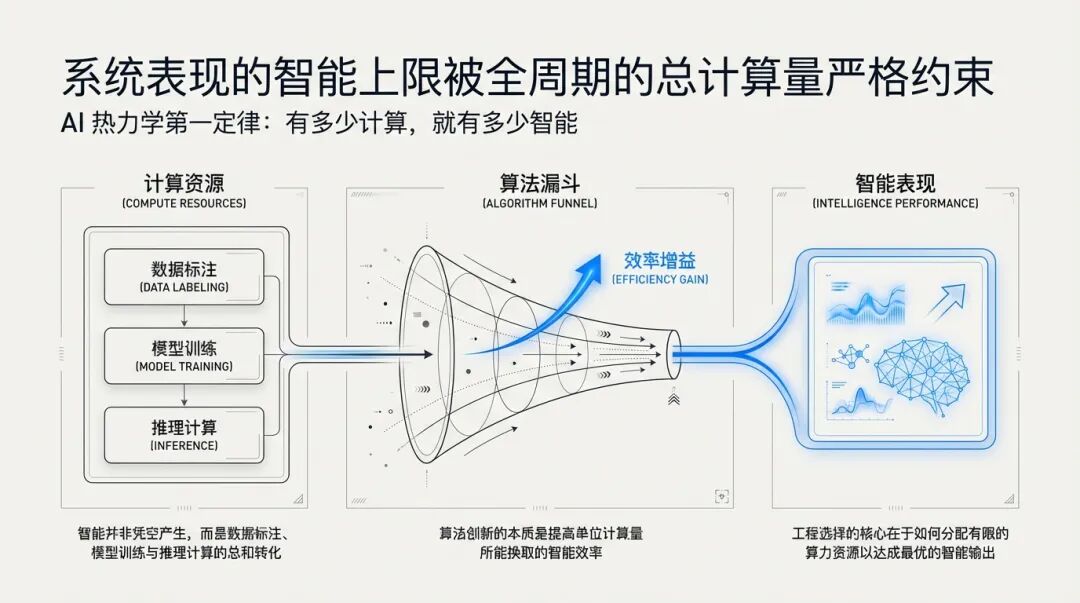
这里说的“计算”,不是某一次调用 GPU 跑了多久,而是一个「全周期的总账本」:
- 数据标注与预处理中的计算投入
- 训练阶段消耗的算力
- 推理阶段持续投入的算力
在这个视角下,我们会发现:
算法、向量、LLM,本质上是三种不同“计算–智能平衡点”的工程选择。
一、AI 热力学定律:智能是算出来的
用热力学来类比:
- 物理世界中:没有能量输入,就不可能凭空出现有序结构;
- AI 世界中:没有足够的计算,就不可能构造出高层次的智能结构。
所以我给这个定律一个更完整的表述:
在相近技术范式下,一个 AI 系统能体现的智能上限,
被它在数据、训练、推理阶段投入的总计算量所严格约束。
算法创新当然很重要,但它更多是:
提高「每一单位计算能换回多少智能」。
说完底层逻辑,我们回到工程实践——也就是我在真实项目里踩坑、总结出来的那部分。
二、工程实践:算法、向量、LLM 的真实差异
1. 算法:快,但不智能
在工业系统里,传统算法(规则、打分函数、状态机、经典优化/搜索)有三大优点:
- 快:毫秒级甚至微秒级响应;
- 便宜:CPU 就能跑,几乎不吃算力;
- 确定性强:结果可预期、可复现、好测试。
问题也非常致命:
不智能。
- 环境一变就要人肉改规则;
- 业务逻辑稍一复杂就变成“规则地狱”;
- 遇到模糊输入、语义理解时几乎无能为力。
不要期待“只靠多写点 if-else / 多调几个权重,就能堆出智能”,
本质上是:
在没有投入足够计算的前提下,不可能有更高阶的智能。
2. 向量 / Embedding:有一点智能,而且也算快
向量/Embedding 是介于“纯算法”和“LLM”之间的中间层:
特点:
- 有一点“语义智能”:
- 向量模型需要训练,推理也需要更大的计算成本
- 能感知相似含义、相近语境;
- 比关键词匹配、规则匹配自然得多。
- 速度和成本相对可控:
- 向量化 + 向量检索,在工程上可以做到秒级;
- 远比 LLM 便宜、稳定。
我的经验是:向量非常适合用在“需要一点智能,但又不能太慢”的地方:
- 语义搜索 / FAQ 匹配(先大致找到“可能相关”的内容);
- 推荐/召回阶段,先拉出一批候选;
- 相似问题/案例的粗匹配。
但要清醒地认识到:
向量的智能是“模糊直觉级”的,不是“严谨推理级”的。
它不适合作为最终决策核心,也不能代替复杂逻辑。
最合适的定位是:智能召回器 / 候选集生成器。
3. LLM:最智能、最慢、最不确定
LLM 是目前工程实践中“最智能”的一块,但它的工程特性也最极端:
优点:
- 理解复杂自然语言指令;
- 能做多步推理与策略规划;
- 能进行内容生成、总结、重写、纠错、解释等复杂任务。
缺点,同样非常明显:
- 1.最慢
- 推理链一长、上下文一大,延迟立即上去;
- 在高并发、强实时系统中,大量同步调用 LLM 是灾难性的。
- 2.有随机性,不可靠
- 同一个问题,多次调用答案可能不一致;
- 会产生“幻觉”、细微逻辑问题,难以 100% 规避;
- 无法像传统算法那样做严格的「输入–输出」映射验证。
- 3.成本高
- 不管是 API 费用,还是自建 GPU 集群,都是实打实的开销。
基于这些特性,我在工程实践中的经验是:
LLM 主要应该用在两类地方:
- 1.链路级的关键决策 / 复杂推理节点
- 比如根据上下文和候选结果,做最终排序、解释、生成答复;
- 决定“走哪条业务路径”、如何组合后续工具调用。
- 2.尽量离线化的环节
- 预计算结构化知识、预生成模板回答、预标注数据;
- 尽量把 LLM 的重计算,从“在线实时”搬到“离线批处理”。
一个很重要的实践原则是:
- 在需要快速反馈的链路(如在线请求主链路),不要大量、同步地依赖 LLM。
而是尽量控制为:
- 少数关键节点调用;
- 有降级策略(超时/失败时退回到算法+向量的兜底);
- 能缓存的尽量缓存,能提前算的尽量提前算。
三、RAG是计算观念的必然
经常能听到一种说法:
“等 LLM 够强了,RAG(检索增强生成)这种东西迟早会被淘汰。”
我认为,这是典型的忽略成本与物理约束的想象,就像拿纯钛来制作桥梁一样。
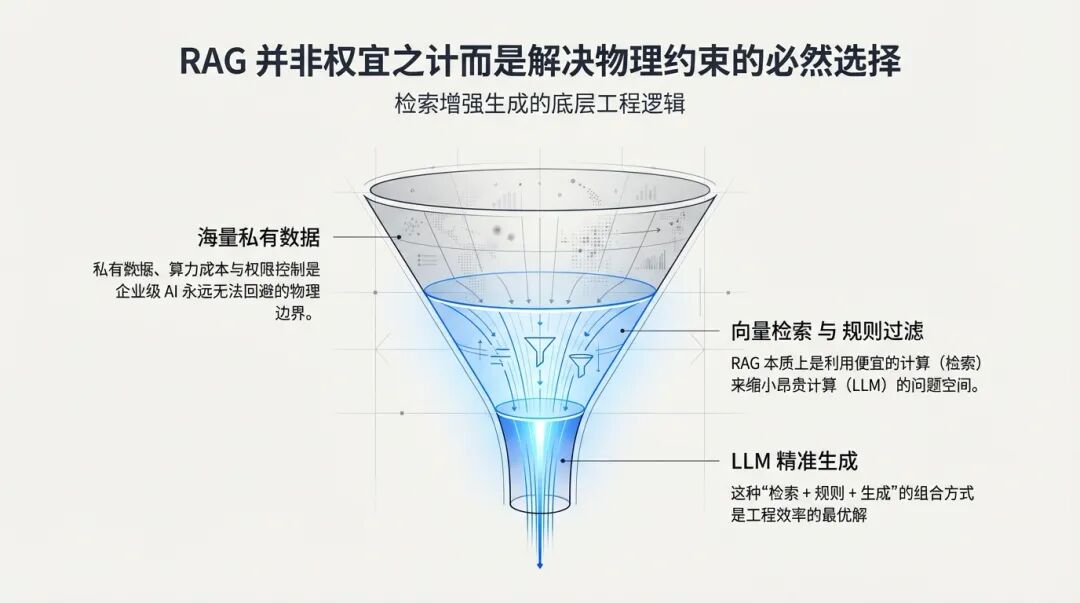
RAG 本质上干的事,就是把这三层的优势合起来用:
- 用 向量 在「你的私有知识 / 业务数据」里做快速粗筛;
- 用 算法 / 规则 去做过滤、约束、排序、权限控制;
- 再把这些结果塞给 LLM,让它在「小而准的上下文」里做高阶理解和生成。
所以,哪怕未来的 LLM 再强,再“接近 AGI”,只要这几个现实前提还在:
- 私有数据永远不可能全部灌进基础模型参数;
- 训练和推理算力永远是有限且有成本的;
- 企业/产品永远需要可控的延迟、成本、权限和可解释性;
那么 RAG 这种「检索 + 规则 + LLM」的组合方式,就不会消失。
它可能会演化、会变得更自动化、更体系化,但它代表的那种架构思想不会死:
- 用便宜的计算,缩小问题空间;
- 用确定性的规则,锁住硬边界;
- 用昂贵的 LLM,只解决那些必须用智能解决的关键部分。
四、SAG:让三者共生
智能是算出来的,但在工程里,你不能在每一处都用最贵的计算去堆智能。
从这个角度看:
- 算法:负责“结构化、确定性的部分”;
- 向量:负责“快速的、模糊的语义智能”;
- LLM:负责“高价值的、高阶推理与生成”。
正是基于这一理念,我设计了下一代 RAG 架构:SAG。
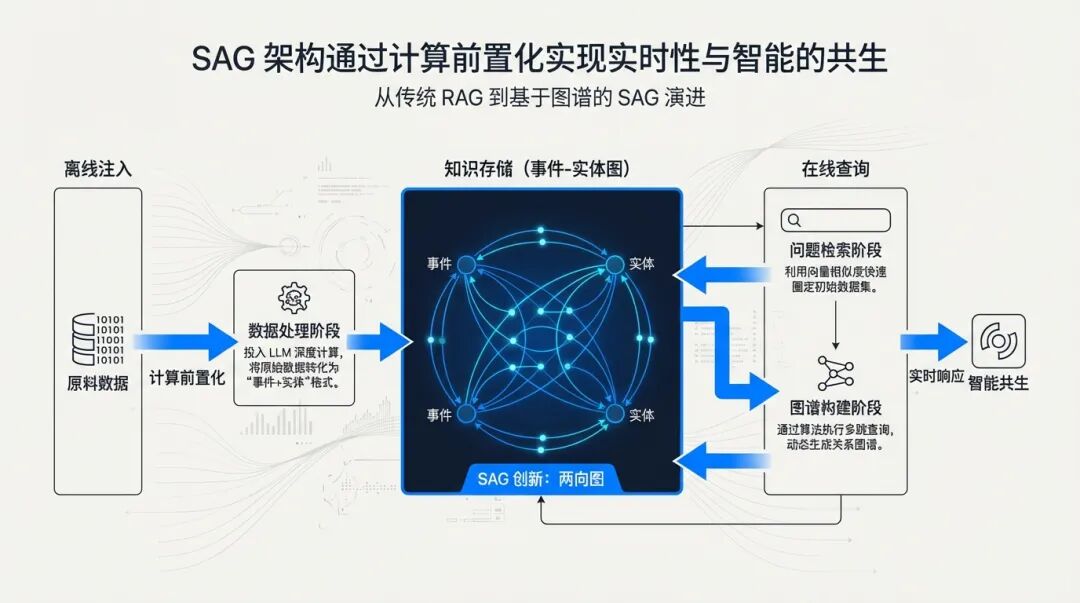
SAG 一句话介绍:通过 LLM 对数据进行深度预处理,并在查询时实时构建知识图谱的RAG技术。
从 AI 热力学定律的视角来看,SAG 的核心设计思想是:
把昂贵的计算"前置化",把实时计算"轻量化"。
整个流程分为三个阶段:
- 数据处理:使用LLM,用充足的智能对原始数据进行解析,统一转化为「事件 + 实体」格式
- 初始检索:使用向量,通过语义相似度,快速圈定与问题相关的初始数据集
- 图谱构建:使用算法,基于初始数据进行多跳查询,高效构建关系图谱
在SAG中,LLM/向量/算法不是三个互相竞争的技术选项,而是:
三种必须被放在一起、辩证使用的基础构件。
具体而言:
- LLM:在离线数据处理阶段注入大量智能——这个阶段对时效不敏感,正适合进行深度计算;
- 向量:在问题检索阶段提供轻量智能——以相似度快速划定答案的候选范围;
- 算法:在图谱构建阶段提供稳定高效的计算——借助事件和实体间的关联,动态构建复杂的知识图谱。
这就是 SAG 的核心逻辑:
用离线的 LLM 计算,换取在线的算法效率;用图谱的确定性,补足向量的模糊性。
SAG的创新在于:我们没有使用传统的三元组(实体-关系-实体)来构建图谱,而是使用了更加简单的两向图(事件-实体)。在查询时,通过相似度传播来查找事件和实体之间的隐含关系,动态的创建图谱。
我们已将SAG框架开源,欢迎大家来共同交流:
https://github.com/Zleap-AI/SAG
五、总结
我认为,真正成熟、长期可持续的路线,不是「All in 某一个」,而是:
- 承认物理边界,尊重计算成本;
- 让三者各司其职、彼此协同;
- 在「速度、效果、成本」之间找到那个真正可落地的平衡点。
当你接受了“有多少计算,就有多少智能”这个AI热力学定律,也接受了“算法 / 向量 / LLM 各自的物理属性和边界”,你就会自然走向这样一种架构观:
不追求某一项技术的“绝对正确”
而是追求在给定资源和场景下
用合适的计算
换取恰到好处的智能
这,才是今天做 AI 产品系统架构时,更接近现实的设计思路。