大家好,我是Jomy。
去年,我们推出了 SAG,一种在多跳检索上达到 SOTA 的 RAG 方法。
效果很好,但工程上还是有些复杂。要先用 LLM 分析文档,提取事项和实体,再把文字转成向量,建立索引。
所以我一直在想:能不能完全去掉向量,达到相似的效果?
今年 JEV 出来后,我感觉机会来了。
我基于 SAG 的核心思想,设计了 SAG2,并经过多轮实验与优化。
没想到,最后在三个公开测试集上,达到了新的 SOTA。
新的 SOTA
论文链接:https://arxiv.org/abs/2610.22588
我们在 MuSiQue、2WikiMultiHopQA 和 HotpotQA 上各测试了一千道问题。
前五条搜索结果找回了多少必要资料,就是 Recall@5;看前十条,就是 Recall@10。我们同时看这两项指标,因为 Agent 需要在尽量少的结果里,拿到完整的证据。
三个测试集,两项指标,SAG2 全部刷新 SOTA。
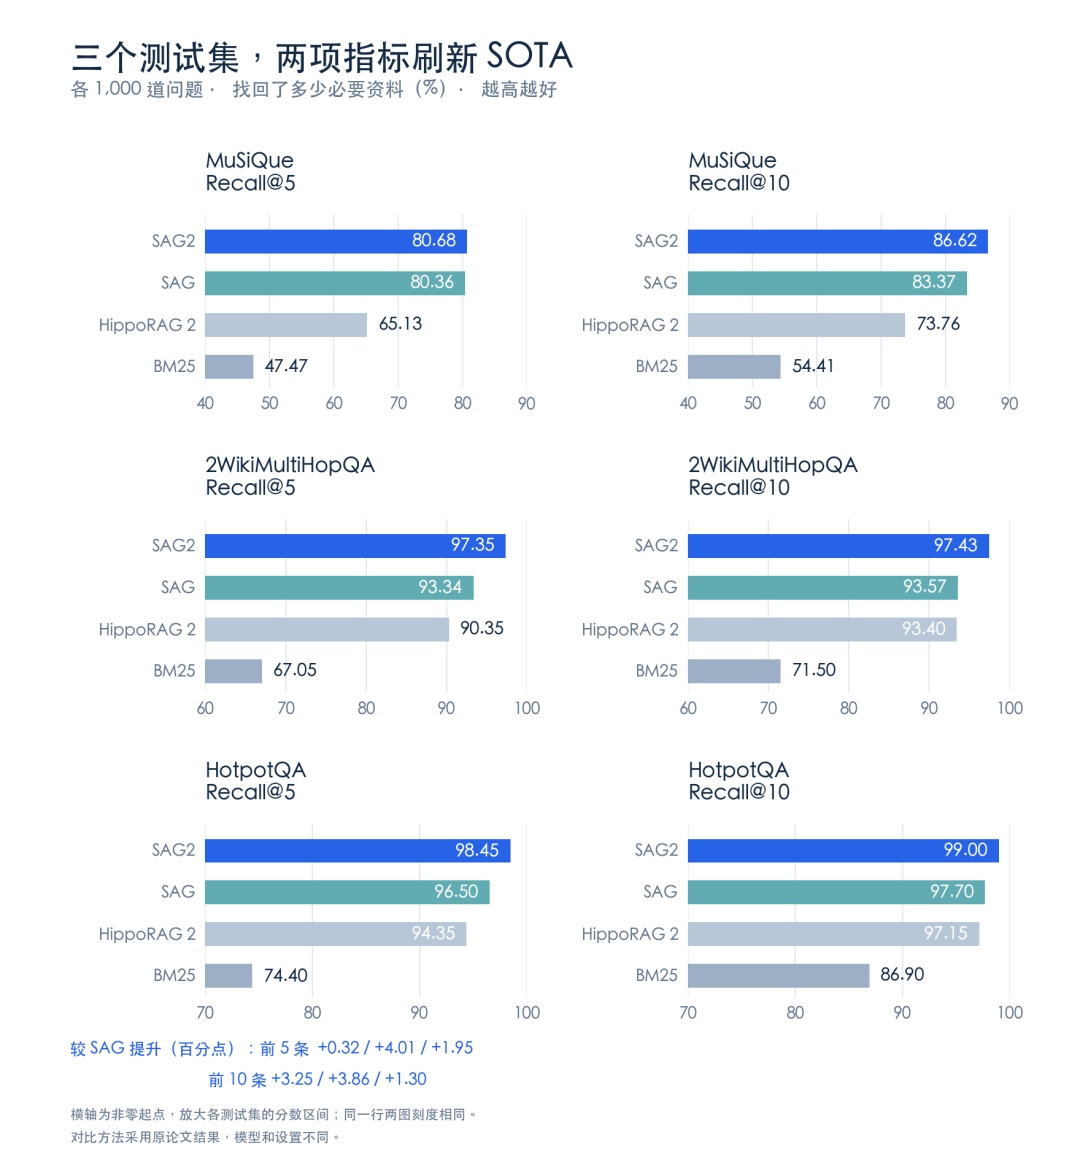
在更难的 MuSiQue 上,SAG2 的 Recall@5 是 80.68%,比 HippoRAG 2 高 15.55 个百分点;Recall@10 是 86.62%,高 12.86 个百分点。
相比我们此前的 SOTA 方法 SAG,2WikiMultiHopQA 的 Recall@5 从 93.34% 提高到 97.35%,HotpotQA 从 96.50% 提高到 98.45%。三个数据集的 Recall@10 分别提高了 3.25、3.86、1.30 个百分点。
提速7000倍
SAG 已经简化了知识图谱的结构。传统图谱要把一段话拆成多条“实体—关系—实体”的三元组;SAG 则保留一个完整的事项,再关联其中的多个实体,形成一对多的超边。这样既保留了上下文,也省掉了逐条抽取关系的工作。
但 SAG 仍要逐段调用 LLM,提取事项和实体。SAG2 直接对原文建立关键词索引,用 BM25 按关键词匹配程度查找内容,整个建库过程不需要 LLM,也不需要 Embedding。
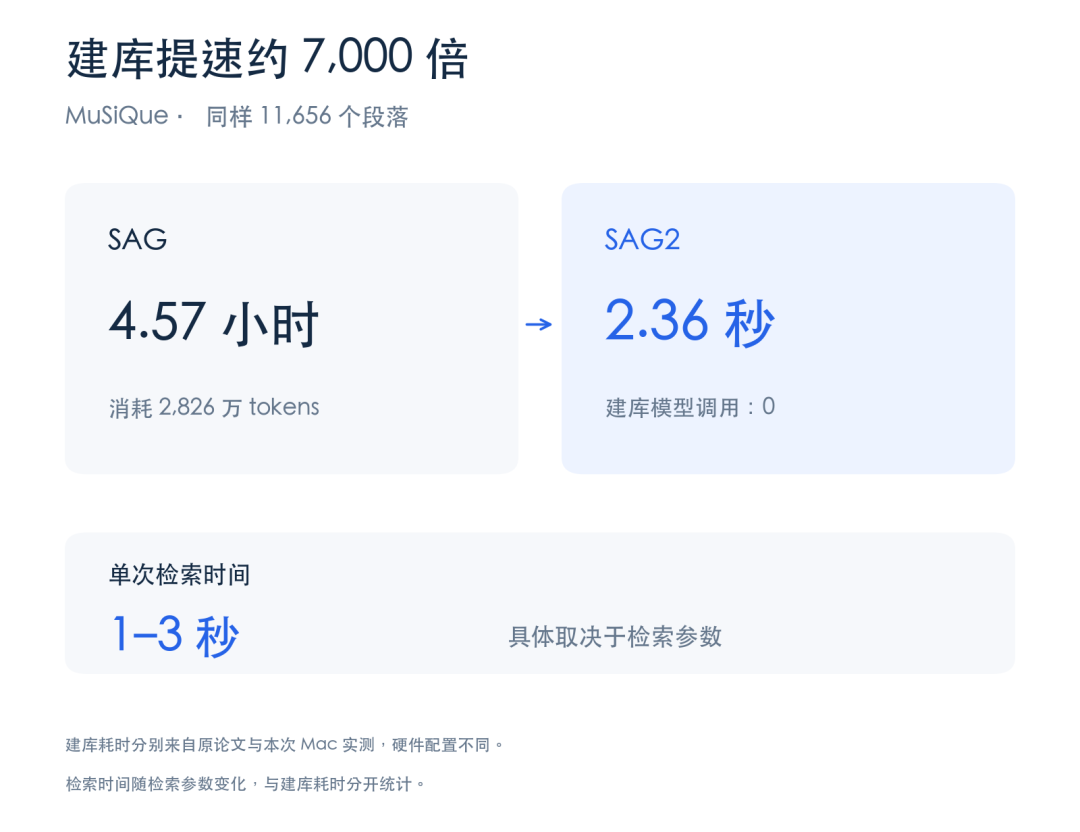
先看 MuSiQue。同样是 11,656 个段落,原 SAG 论文(https://arxiv.org/html/2606.15971v2)报告的建库时间是 4.57 小时,消耗 2,826 万 tokens。
这次,我们在一台 M4 Pro、64 GB 内存的 Mac 上,从空数据库连续重建三次,中间值只有 2.36 秒。
从 4.57 小时到 2.36 秒,两次记录的建库耗时相差约 7,000 倍。
我们又在更大的语料上做了验证:511,962 个文档,约 24.65 亿字符,完成文件清点、建库和完整性检查,总共用了 8 分 32 秒。
折算下来,每百万字符只需约 200 毫秒。
所有文件,都可以成为知识库
天下武功,唯快不破。
当建库只需要这么短的时间,很多产品逻辑也变了。以前做知识库,要先挑选文件、上传,再等待模型处理。现在,能读取的文件,就可以直接成为知识库。
我们基于 SAG2 做了一个桌面应用:SAG Wiki。选择本地文件夹,就能对其中支持的文档、笔记和代码进行搜索、问答,并回到原文查看依据。
安装包依然很轻:Windows 版约 9.5 MB,macOS 版约 12.5 MB。文件留在原来的目录,提问时,由配置的模型根据检索结果回答。
单次检索通常需要 1–3 秒,具体取决于检索参数。
应用已经开源,欢迎大家试用:
https://github.com/Zleap-AI/SAG-Wiki
为什么这么快,效果又这么好
我一直有一个“智能守恒”的定律:有多少计算就有多少智能。
把文字转成向量的 Embedding,是一种介于简单计算和 LLM 之间的弱智能,可以做快速、模糊的匹配。而 JEV(https://typesafe.ai/blog/introducing-system-one-models-and-jev) 恰好也在这个位置,擅长快速判断内容是否有用。
给它问题、候选段落和已经找到的证据,它就能直接给出判断分数,无需生成一大段分析文字。语义判断因此可以留到提问时,只处理当前问题需要的候选。
但要做好多跳检索,还需要把分散的内容联系起来。这是 SAG 留给 SAG2 的核心思路。
SAG 用“事项—实体”的动态超边组织内容,验证了这种结构化方式的检索优势。
SAG2 把它改成“关键词—段落”的动态超边。一个关键词可以连接多个段落,一个段落也包含多个关键词,联系直接来自原文。
SAG:事项 → 实体 → 另一个事项
SAG2:段落 → 关键词 → 另一个段落
检索时,先用 BM25 找到候选,再由 JEV 判断哪些包含有用的证据。算法从这些段落里选出关键词,继续查找关联段落;JEV 再结合已有证据,判断新找到的内容。
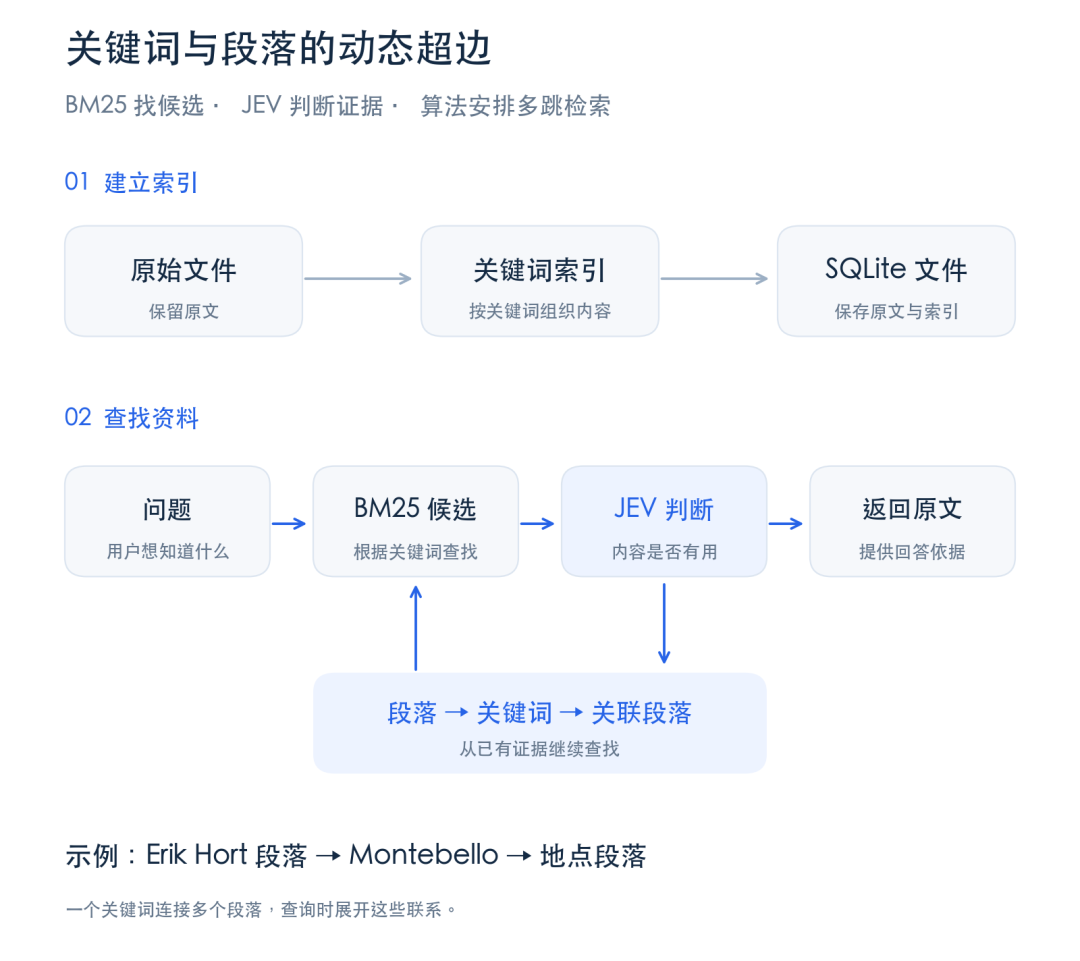
比如论文里的问题:Erik Hort 的出生地属于哪个县?
第一次检索找到人物段落,得知他的出生地是 Montebello。算法再用 Montebello 继续检索,找到介绍这个地点的段落。把两段原文结合起来,就能回答这个问题。
这就是多跳检索。SAG2 保留了 SAG 动态超边的结构优势,同时省掉了提前提取事项和实体的工作。
五十万企业文档上的检验
学术问答之外,我们还完整测试了 EnterpriseRAG-Bench(https://arxiv.org/abs/2605.05253)。前面那批五十多万份文档,就来自这个数据集。
它按企业知识场景构造文档,模拟邮件、消息、工单和会议记录。同一个问题的依据,可能分散在不同项目、不同文件里,还涉及条件限制和信息冲突,比维基百科问答更接近企业的实际需求。
这个规模也让完整实验变得很昂贵。24.65 亿字符,抽样估计光原文就约合 6 亿 tokens。 逐段调用 LLM,还要加上重复的提示词和生成结果。
一项针对 EnterpriseRAG-Bench 的规模研究(https://arxiv.org/html/2607.26497v3)中,四种图谱类方法在其测试条件下都未完成全量评测:LightRAG 只完成了 2,254 个文档,MS-GraphRAG 为 8,750 个,HippoRAG 2 和 LinearRAG 止于 131,876 个,都未达到约 51 万文档的完整规模。
我们之前估算过,按 SAG 一代的方案,本地 GPU 可能需要跑 7 天。依赖 LLM 逐段预处理的框架,完成一次实验就需要很高的成本,反复测试不同版本更难。
SAG2 这次使用全部 511,962 个文档完成检索评测,完整跑分大约只花了一个多小时。
其中 470 道问题给出了需要找回的参考文档。SAG2 在前十条结果中找回了 81.10% 的所需文档,也就是文档 Recall@10。
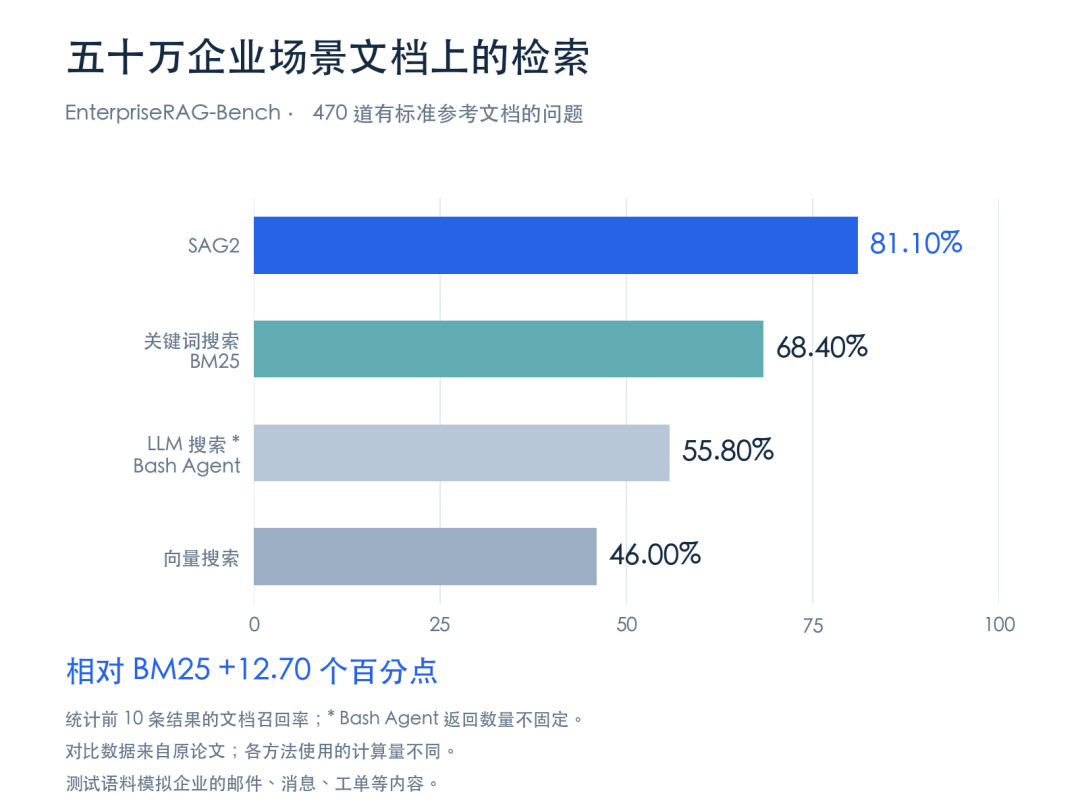
基准论文报告的结果中,BM25 为 68.4%,向量检索为 46.0%,Bash Agent 为 55.8%。SAG2 相比 BM25 提高了 12.70 个百分点。
Bash Agent 让 LLM 执行搜索命令、阅读资料,再决定下一步。SAG2 的检索过程没有调用 LLM,搜索步骤由算法决定,JEV 负责判断证据,在这项测试中比 Bash Agent 高出 25.30 个百分点。
在 SAG Wiki 中,我们把这两种能力结合起来:让 Bash Agent 通过命令行调用 SAG2,先取得相关证据,再根据已有结果决定是否继续查找。
Agent 调用 SAG2,甚至可以比单独使用 SAG2 更准。 在 MuSiQue 的一千道问题上,这种组合的 Recall@10 从 86.62% 提高到了 95.39%。SAG2 负责精准查找,Agent 负责进一步理解问题和补充检索。
面向 Harness,也面向记忆
这套方案也很适合今天的 Harness。
SQLite 本身就是一个文件。原文和索引都保留在文件系统里,不需要额外部署数据库服务。Agent 调用一次搜索,就能拿到多跳检索后的原文证据,继续完成任务。
我们做过一项实验:用 SAG2 替代 grep,作为 Agent 可调用的工具。在相关任务中,Token 消耗减少了约三分之二,任务完成效果也更好。
凭借极简、低成本和高精度的优势,SAG2 可能会成为各类 Harness 普遍采用的文件检索方案。
记忆也是一样。Agent 需要从多条记录中找到相关内容,识别它们之间的联系,再用于当前任务。SAG2 的多跳结构和低成本,同样适合这个过程。
在没有做任何适配的情况下,我们在 LOCOMO 和 LongMemEval 两个记忆数据集上,也取得了 SOTA 的成绩。相关论文很快会发布,先在这里做一个小预告。
本地部署也有替代方案。我们尝试用 Rerank 模型代替 JEV 判断候选段落,Recall@10也达到了可以接受的效果,可以用于本地部署。JEV 尚未开源,架构也没有公开,目前本地替代模型还达不到它的速度和效果,这也是接下来可以继续优化的方向。
正式开源
今天,我们正式公布 SAG2 论文,并开源这套方法和 SAG Wiki 应用。
之前的 SAG 获得了很多人的关注,我们也陆续收到反馈:不少人基于 SAG 构建了很好的应用。看到研究成果被真正用起来,我们很高兴。
对我来说,SAG2 又是一场新的革命。更简单的结构、更低的成本,让更多人能够用上高精度的多跳检索。
如果你觉得这项工作有价值,希望能给我们的开源项目点个 Star,也欢迎把文章分享出去,让更多人知道、用上这项技术。
也期待大家基于 SAG2 做出更多应用,无论是知识库、Agent 记忆,还是未来的推荐场景。欢迎大家来我们的微信群交流你们的想法和使用体验。
论文:https://arxiv.org/abs/2610.22588
论文代码:https://github.com/Zleap-AI/SAG-Benchmark
桌面应用:https://github.com/Zleap-AI/SAG-Wiki
交流群:Zleap公众号 - 联系我们 - 扫码进群