论文链接:https://arxiv.org/abs/2606.15971
开源链接:https://github.com/Zleap-AI/SAG
大家好,我是 Jomy,本周我会连续三天发表三篇文章,来向大家汇报一下我们 Zleap 近期的一些成果。今天我们先讲 SAG。
这两年,几乎所有 AI 应用都绕不开一个问题:
模型能力越来越强后,Agent 完成任务的质量,越来越取决于它能拿到什么上下文。
上下文不够,就用 RAG 去检索。
但复杂任务里,一次检索往往不够。
所以最近流行的 Agentic RAG,本质上就是让模型多检索几轮:先拆问题,再循环检索、阅读结果,最后决定下一步查什么。
这听起来很合理。
但如果每一步都搜不准,让模型重复思考、检索、判断,系统很快会遇到另一个问题:
token 越用越多,延迟越来越高,不确定性也会在每一轮里叠加。
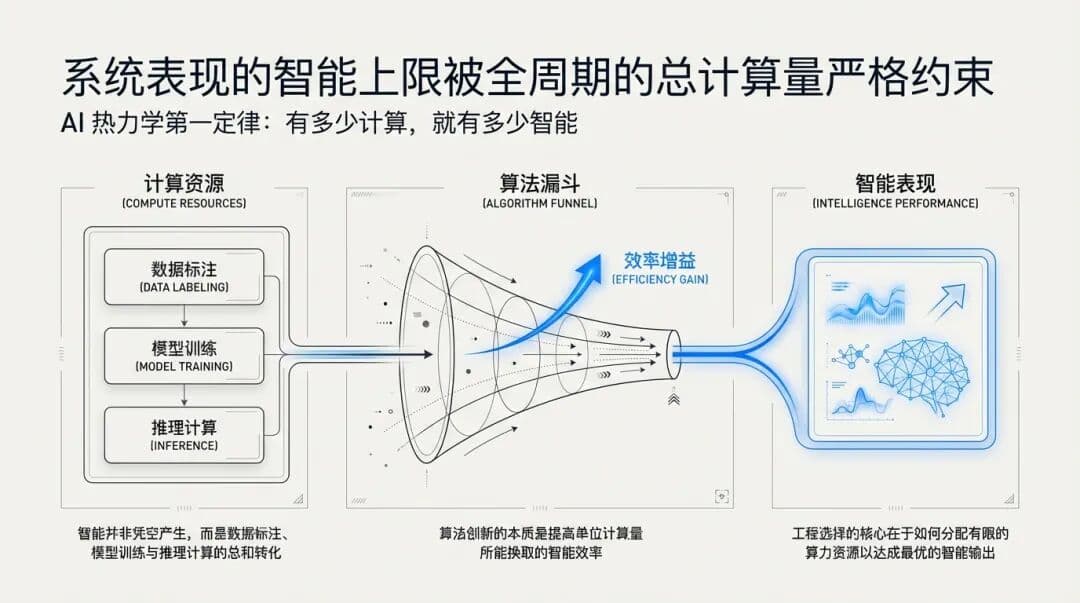
我之前提出过一个观点:有多少计算,就有多少智能。
但真正关键的问题是:这些计算到底应该发生在哪里?
是每次用户提问时,让 Agent 临时查、临时想、临时组织上下文?
还是在数据进入系统的时候,就先把该整理的东西整理好?
问题不在于 Agent 能不能多搜几轮,而在于海量上下文进入系统时,是否已经被整理成可持续使用的数据底座。
这就是今天这篇文章要回答的问题。
从开始立项,到去年11月初步开源 SAG 第一个版本,最后到今天正式发布论文和 benchmark 结果,我们研究了一年。
今天我来向大家详细讲讲,我们为什么要从底层重新思考 RAG。
RAG 的瓶颈
传统向量 RAG 最大的优点,是快。
它把每段文本变成向量,问题来了,就找几段最像的文本。
这个逻辑适合静态文档场景:数据少,问题简单,答案就在某个段落里。
但它有一个根本限制:
向量搜索只知道“像不像”,不知道“谁和谁发生了什么关系”。
比如一个多跳问题,答案可能分散在几个文档里:
A 公司收购了 B 公司,B 公司的 CTO 后来加入 C 项目,C 项目又影响某个产品路线。
这些信息单独看,未必和问题特别相似。连起来,才是答案。
向量 RAG 很难稳定找到这条链。
GraphRAG 的方向是对的。它意识到文本里有实体、有关系、有结构。
但 GraphRAG 又太重。
很多 GraphRAG 系统会把文本抽成三元组,做实体合并、关系归一、社区发现、社区摘要。每一步都依赖 LLM,每一步都可能出错。
更麻烦的是,图谱不是一次性建完就结束。真实世界的数据每天都在变:新实体、新别名、新关系会不断出现,旧关系和旧摘要也可能过时。
维护一张大图,往往比建一张大图更难。
HippoRAG 2 是目前非常强的方向,它证明了 RAG 不能只靠向量,必须结合结构化记忆和多跳检索。
但 HippoRAG 2 最大的问题,是依赖全局 Personalized PageRank / PageRank 类图排序。
这在 benchmark 规模下可以工作。但如果数据到了海量规模,并且每天增量增长,全局 PageRank 就会变得很重。
对 Agent 来说,数据底座必须持续写入、持续更新、可追溯、可回滚。不能每来一批新数据,就把全局图重新算一遍。
所以我们需要一种新的结构化文档格式。
(从 NaiveRAG 到 GraphRAG,再到 SAG:结构化不是越重越好,关键是能不能支撑增量、多跳和真实 Agent 场景。)
SAG 的结构
SAG 的核心结构很简单:
chunk -> event chunk -> entities event <-> entities
一个 chunk,对应一个事项 event。
同一个 chunk 里抽取出的多个实体 entities,会和这个 event 关联起来。
这和传统图谱的三元组路线不同。
三元组是:
主体 -> 谓词/关系 -> 客体
在知识图谱里,也经常写成:
头实体 -> 关系 -> 尾实体
比如:
SAG -> 使用 -> 超图
SAG -> 存储 -> 事项
SAG -> 支持 -> 多跳检索
问题是,它会把一段完整语义拆得很碎,而且质量高度依赖谓词/关系抽取得准不准。
同一件事,不同模型可能抽出不同谓词:使用、基于、提出、支持。到了真实数据里,这种差异会迅速放大。
SAG 不这么做。
我们让 LLM 做两件更稳定的事:把一个 chunk 总结成一个完整、可独立理解的事项,同时从原始 chunk 里应提尽提地抽取实体,再把这些实体和 event 关联起来。
event 保留语义。
entities 来自原始 chunk,负责索引。
所以 SAG 本质上不是“把关系抽得更准”,而是给原始数据加了一层语义索引。
在图结构上,这更像超边:一个 event 同时连接多个实体。
它不是两个点之间的一条边,而是一件事把多个实体组织在一起。
这比三元组更适合 RAG。
因为 RAG 最后还是要回到原文证据。三元组太碎,容易丢上下文;event 保留上下文,同时提供可检索、可扩展的结构。
这就是 SAG 的核心:
不是更重的图谱,而是更轻、更鲁棒的数据索引。
新 SOTA
先看结果。
简化后的 benchmark 图:突出平均 Recall@2、MuSiQue Recall@5,以及超边结构相对三元组结构的提升。
我们在相同 Embedding 和 LLM 配置下,对比了 HippoRAG 2。
Embedding = bge-large-en-v1.5
LLM = qwen3.6-flash
数据集是 HotpotQA、2WikiMultiHop、MuSiQue。
SAG 平均 Recall@2,HippoRAG 2 是 68.14%。提升 11.16 个百分点,相对提升约 16.4%
这比 Recall@10 更重要。
Agent 不希望每次拿回一大堆上下文。它真正需要的是,在更少结果里,更早命中关键证据。
否则后面 LLM 要读更多内容,成本更高,延迟更高,干扰也更多。
MuSiQue 是更难的组合式多跳数据集,这个提升说明 event/entity 索引确实在复杂关联问题里起作用。
这里需要补充一个实验背景。
HippoRAG 2 在 bge-large-en-v1.5 下的分数会偏低一些。它在原论文里使用的是更大规模的 NV-Embed-v2,MuSiQue Recall@5 大约是 74%。
但 embedding 模型对 SAG 的影响并没有这么大。
SAG 在 bge-large-en-v1.5 下 MuSiQue Recall@5 是 80.04%,换成 NV-Embed-v2 后是 81.71%。
这也侧面说明,SAG 的提升不是单纯靠 embedding 模型堆出来的,而是来自算法结构本身的鲁棒性。
我们还做了三元组式结构和事项超边结构的对比。
在 MuSiQue 上,三元组式 1-n-2 结构的 Recall@5 是 77.16%。
SAG 当前的一事项多实体超边结构,Recall@5 是 80.04%。
这个实验说明,SAG 的超边结构确实比三元组更适合 RAG 检索。
更重要的是,它不是靠更复杂取胜。恰恰相反,它更简单。
三元组要把关系拆细,要依赖每条关系抽得准不准。
SAG 只需要保留一个完整事项,再从 chunk 里应提尽提地抽取实体做索引。
结构更轻,效果反而更好。
我们还做了非常充分的消融实验来证明这些设计选择,更多细节可以查看我们的论文。
流程详解
SAG 分两步:离线写入,在线检索。
离线写入时,系统先把文档切成 chunk。
每个 chunk 提取一个 event。
同时从这个 chunk 里提取多个 entities,应提尽提。
最后写进数据库。
同时写入向量索引和全文索引。
也就是说,SAG 不是只存原文。
它存的是一套可以被 SQL 查询、向量召回、全文检索、多跳扩展的数据结构。
拿到 seed events 之后,SAG 没有什么神秘的智能。
就是在 SQL 里做关系扩展:
先取出 seed events 关联的 entity ids。
再通过 event_entities 表查这些 entities 还连接了哪些 events。
排除已经出现过的 event,得到下一批候选 events。
这就是多跳。
它不是全局 PageRank,也不是临时让 LLM 推理一张图。
就是数据库里的关系扩展。
最后再把 event 映射回原始 chunk。
因为回答不能只靠抽象事项,必须回到原文证据。
SAG 现在主要有两个模式:
简单说:
快速模式负责快。
高精度模式负责更准。
但两者都不是传统 RAG,因为两者都使用了 SAG 的 event/entity 索引。
所以上面的架构图展示的是高精度模式,图里包含 LLM 参与精排;快速模式会去掉这一步,但仍然保留多跳检索。
规模化
真正的规模化,不是把图做大。
而是让数据可以一直写进去。
这也是 SAG 和很多 GraphRAG 路线最大的区别。
SAG 不需要提前维护一张全局知识图谱。
新数据进来,就切 chunk,从 chunk 抽 event 和 entities,写入 SQL。
这更像数据库的增量写入,而不是图谱的全局重建。
还有一个关键点:
chunk 是天然的并发单元。
每个 chunk 的 event/entity 提取可以独立跑。所以写入侧可以大批量并发处理 chunk。
抽取 event 可以并发,生成 event/entity/relation 向量也可以并发。
这不是一个只能串行慢慢建图的流程。
这也是 SAG 能 scale up 的关键。
有人可能会问:
并发抽取的时候,相同实体怎么办?
我们的处理很简单。
没有做复杂的实体合并,也没有做很重的 entity resolution。
每个实体入库前,先做简单字符串归一和 SQL 查询。
同一个 source 下,如果同类型、同名字的实体已经存在,就直接复用;不存在,再插入。
这件事很朴素,但恰恰说明 SAG 的鲁棒性。
它不是依赖一个完美的实体合并系统才能工作。
即使只是简单字符串校验和 SQL 查重,SAG 的一事项多实体结构也已经能跑出现在的效果。
因为 entity 在 SAG 里首先是索引点,不是所有语义本身。
真正保留语义的是 event。
为了证明 SAG 在生产环境里的可用性,我们也在真实数据规模上做了验证。
我们已经把网上海量数据抓取下来,在数据库里形成了 5 亿级数据,并且还在持续增长。
在这个规模下,SAG 仍然可以稳定运行。
为了让大家更好地在线体验我们的 SAG 技术,我们做了一个 Wikipedia 的 SAG 案例。
我们把 wiki 抓下来分析,放进 SAG 里,大家可以直接测试多跳检索效果。
Agent 数据底座
为什么说 SAG 是面向 Agent 的数据底座?
因为 Agent 和普通问答系统不一样。
普通问答系统检索一次,答一次。
Agent 往往要连续查很多次。
它先查一个线索,再根据线索查下一个线索,再根据新的结果决定下一步。
这时候,检索准确率就不只是“体验问题”,而是整个任务链路的稳定性问题。
如果第一次查错,后面的推理会建立在错误材料上。
如果第一次没查到,Agent 可能换一个错误方向继续查。
疑难任务里,这种错误会叠加。
查得越多,偏得越远。
最后不是“多查几次总能找到”,而是可能永远查不到。
所以,更准的检索有两层价值:
第一,用更少的查询次数找到正确内容。
第二,在必须多次查询时,降低每一步错误叠加的概率。
数据底座的意义,不是优化单次问答,而是提高 Agent 整条行动链路的可靠性。
记忆是数据底座上的另一个典型场景。
为什么 SAG 能做记忆?因为记忆不是孤立文本,而是会不断变化的数据。
同一个用户、项目、偏好,可能在不同时间反复出现。新的记忆可能补充、修正,甚至推翻旧记忆。
纯向量记忆更像是在找相似文本,但 Agent 需要知道:哪些是历史背景,哪些是当前状态。
SAG 的结构正好适合这个问题:event 保留完整事项,entities 把同一个人、项目、任务、偏好连接起来,SQL 里再加时间、来源和关联 id。
上面这个例子里,向量检索可能同时召回两条,但不一定知道哪条更新。SAG 可以通过 A 项目、用户、任务状态这些实体关联两条记忆,再结合时间和关联 id 找到当前状态。
所以 SAG 能做记忆,不是因为多加了一个 memory 模块,而是因为它本身就在给数据建立“事项、实体、时间、关系”的索引。
这才是 Agent 可以长期使用的数据结构。
总结
RAG 的下一阶段,不是把 top-k 调得更大,也不是把上下文窗口塞得更满。
而是重新设计数据进入 Agent 的方式。
SAG 做的事情,可以概括成三点:
- 第一,用
chunk -> event、chunk -> entities、event <-> entities给原始数据加一层轻量索引。 - 第二,用 SQL 关系扩展、向量检索和全文检索,把多跳检索做得更快、更稳。
- 第三,让数据可以增量写入、并发处理、持续增长,成为 Agent 可以长期依赖的数据底座。
这也是为什么我们认为,SAG 不是一个新的 RAG 补丁。
SAG 改的是数据进入检索系统、进入 Agent 系统的组织方式。
它代表的是下一代 RAG 的一个新范式:从文本召回,走向结构化数据底座。
下一篇文章,我会给大家分享一下,我们是如何基于 SAG,创造了一个带稀疏注意力的 Agent Harness,明天见!